Der Ausfallmelder, der kein Ausfallmelder ist
Problem
Am 23. September meldete ein Workflow in meiner n8n-Instanz einen Fehler beim Mailversand. Gebaut hatte ich ihn, um Sicherheitshinweise zu verschicken. Dass er einmal der einzige Grund sein würde, überhaupt hinzusehen, war nicht der Plan.
Der Blick ergab: Der Mailserver nahm seit dem Vortag keine Mail mehr an. Knapp zwanzig Stunden, von 12:17 Uhr MESZ am 22. September bis 08:16 Uhr am Morgen darauf.
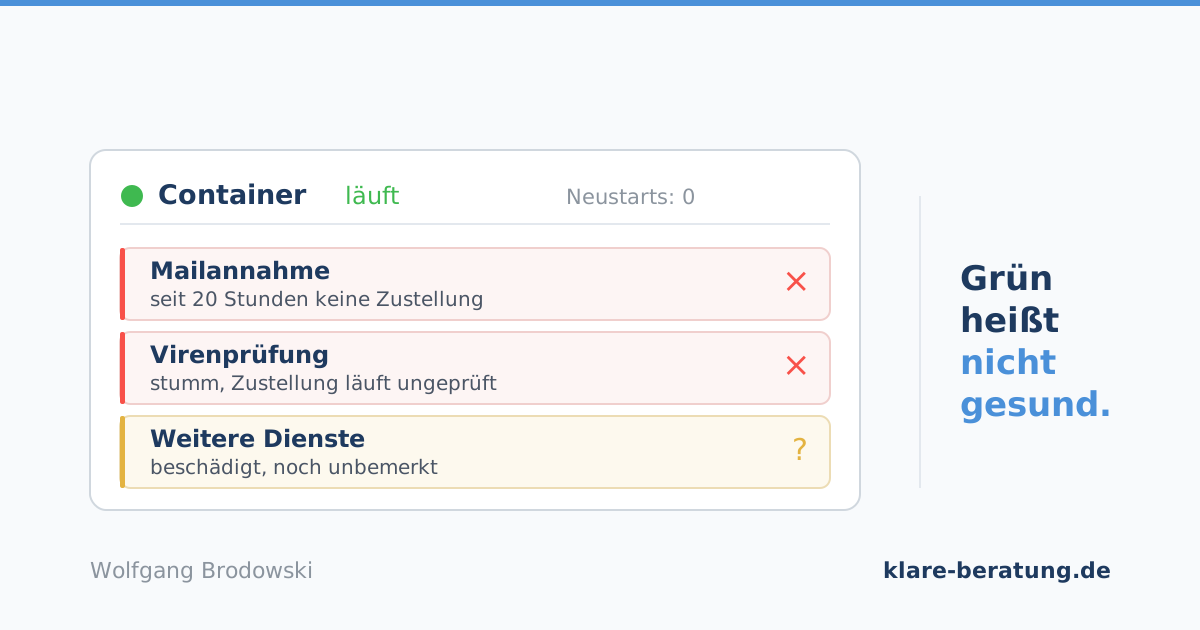
Nichts davon war sichtbar gewesen. Der Container meldete durchgehend, dass er laufe, ohne einen einzigen Neustart. Die Verwaltungsoberfläche zeigte den Dienst als aktiv. Die Ports standen auf dem Host offen, weil der Docker-Proxy sie hält, unabhängig davon, ob dahinter noch etwas lauscht. Ein Portcheck von außen hätte grün gezeigt. Der vorhandene Healthcheck lief alle fünfzehn Minuten durch und meldete alles in Ordnung, weil er nur prüft, ob eine Datei existiert.
Ursache war ein Upgrade von Coolify, der Management-Software, die auf meinen Hosts die Dienste verwaltet. Der Stand war alt, das Upgrade überfällig, und der Sprung ging über mehrere Versionen mit Breaking Changes. Statt einfach auf die jeweils aktuelle Fassung zu gehen, wollte ich eine bestimmte Version ansteuern, um den Schritt kontrolliert zu halten. Dafür nennt die Dokumentation genau einen Weg, und dieser Weg schreibt Eigentümer und Zugriffsrechte rekursiv über das gesamte Datenverzeichnis. Darunter liegen auch die Nutzdaten aller verwalteten Dienste, nicht nur die Interna der Management-Software. Betroffen waren 1149 von 1324 Pfaden allein im Mailserver-Baum.
Dazu kommt ein Detail, das die Sache von einem unglücklichen Nebeneffekt zu einem Konstruktionsfehler macht: Das Skript gliedert sich in neun nummerierte Schritte, beginnend mit der Prüfung der Systemvoraussetzungen. Die Schreibzugriffe laufen davor. In einer Phase, die sich als Prüfung ankündigt, erwartet niemand, dass bereits etwas verändert wird.
Lösung
Die ursprünglichen Rechte waren nirgends dokumentiert. Aus dem laufenden System ließen sie sich nicht rekonstruieren, weil das Mailserver-Image beim Start zwar Eigentümer wiederherstellt, aber keine Zugriffsmodi. Es gab also für weite Teile keine Quelle für den Soll-Zustand.
Die Wiederherstellung lief in vier Eingriffen über drei Verfahren, in aufsteigender Reihenfolge dessen, was ich nicht wusste.
Zuerst Postfix, mit einem einzigen Befehl und ohne Backup. Dem Wurzelverzeichnis des Spool-Baums fehlte das Traverse-Bit, die Unterverzeichnisse darunter waren intakt. Der richtige Wert stand in der Fehlermeldung selbst und ergab sich aus dem Vergleich mit ebendiesen Unterverzeichnissen. Danach lief die Mailannahme wieder, die wartenden Nachrichten kamen durch.
Dann Blog und Clear Wicket, ebenfalls gezielt von Hand. Jeweils ein Befehl auf die Benutzerkennung, die das Image erwartet. Auch hier ohne Backup, weil die erwarteten Werte aus der Container-Konfiguration ablesbar waren.
Dann Virenprüfung und Scanner, erstmals mit Backup. Hier waren die Soll-Modi nicht mehr erschließbar, weil sie von der Gruppenbeziehung zwischen zwei Diensten abhingen. Ein Verzeichnis musste für eine Gruppe erreichbar sein, ein anderes für einen Dienst lesbar, der unter einer dritten Kennung startet. Solche Werte kann man nicht aus einem Symptom ableiten. Sie kamen aus meinem Restic-Backup, das Modi und Eigentümer jedes Pfades mitsichert. Das war die Stelle, an der klar wurde, dass Raten nicht reicht.
Zuletzt der Rest per Skript, über 912 Pfade, rund acht Stunden nach dem Wiederanlauf von Postfix. Und hier der Punkt, der mir wichtig ist: Repariert wurde nicht rekursiv. Grundlage war ein Snapshot von zwei Minuten vor dem Schaden. Aus dessen Inhalt entstand das Skript, das für jeden Pfad einzeln den Soll-Wert ausliest und einzeln setzt, mit vorherigem Probelauf und Abbruchbedingungen. Dieselbe Operation, die den Schaden angerichtet hat, ist in ihrer pfadweisen Variante das Mittel, ihn zurückzunehmen. Der Unterschied liegt nicht im Befehl, sondern darin, ob er pauschal wirkt oder auf Grundlage bekannter Werte.
Ergebnis
Zwischen dem Wiederanlauf von Postfix und dem systematischen Abgleich lagen acht Stunden. Das war keine Strategie, sondern ergab sich. Den Umfang des Schadens kannte ich zu Beginn nicht. Er wurde erst sichtbar, als der erste Defekt behoben war, also der Mailempfang.
Genau daraus entstand der zweite Fund. Solange nichts zugestellt wurde, konnte nicht auffallen, dass auch die Virenprüfung nicht mehr an ihre Verzeichnisse kam. Erst als wieder Mail ankam, trugen die Betreffzeilen den Vermerk, dass ungeprüft zugestellt worden war. Die Reparatur des lauten Fehlers machte den leisen sichtbar.
Auch nach dieser zweiten Reparatur hätte der Vorgang enden können. Der Mailserver lief wieder vollständig, die Ursache war bekannt, beide Defekte waren behoben. Kein anderer Dienst zeigte etwas an, es gab keine Meldung und keine Beschwerde. Nichts deutete auf weitere Schäden hin.
Die Frage, die ich trotzdem gestellt habe, kam nicht aus einem Symptom, sondern aus der Kenntnis der Ursache: Wenn das Skript rekursiv über den gesamten Baum gelaufen ist, wer ist dann noch betroffen? Die Antwort waren zwei weitere Dienste, die niemand gemeldet hatte. Beim einen wäre es nach fünf Minuten aufgefallen, wenn jemand hingesehen hätte. Beim anderen dauerte es acht Stunden, bis überhaupt ein Beleg entstand, und zwar nicht durch ein Monitoring, sondern weil ein Besucher einen Blogartikel mit einem betroffenen Bild öffnete und der fehlgeschlagene Zugriff im Log landete. Gemeldet hat er nichts. Er hat die Seite verlassen, und ohne die spätere Suche wäre der Eintrag nie gelesen worden.
Bleibt die Beobachtung, um die es hier eigentlich geht. Werkzeuge, die für einen Zweck eingeführt wurden, tragen im Ernstfall einen anderen. Das Backup war als Schutz vor Datenverlust gedacht und wurde zur einzigen verbliebenen Dokumentation von Dateirechten. Der Sicherheits-Workflow in n8n sollte Hinweise verschicken und wurde zum Ausfallmelder. Beides war nicht so geplant, und beides hat getragen.
Die Kehrseite gehört dazu. Ein Container kann mehrere kaputte Dienste enthalten und trotzdem grün leuchten. Statusanzeigen auf Containerebene sagen nichts über die Dienste darin. Und keines der beiden Werkzeuge hat die eigentliche Lücke geschlossen, nämlich die zwanzig Stunden bis zur Entdeckung. Der Workflow lief planmäßig, daran war nichts zufällig. Zufällig war nur, dass ausgerechnet er auf den Mailversand angewiesen war und damit als einziger Dienst auf dem Host den Defekt überhaupt berühren konnte.
Was danach passierte, gehört für mich zur Arbeit dazu. Einen Fehler zu beheben reicht nicht, wenn er reproduzierbar ist und andere genauso trifft. Ich habe den Fehler im Upgrade-Skript gemeldet, belegt mit Zeitleiste und Messwerten, und in einem zweiten Bericht die Frage der Reihenfolge nachgereicht. Ein Contributor wies mich auf ein zweites, unschädliches Skript für versionierte Upgrades hin. Ich nutze es seitdem. Weil es in der Dokumentation nicht auftaucht, während dort der schreibende Weg steht, habe ich das getrennt gemeldet. Andere werden sonst genauso hineinlaufen.
Der Vorgang war nicht zu Ende, als der erste Fehler weg war. Er war zu Ende, als nichts mehr zu finden war.